

9 دقیقه
معرفی Robotics-0
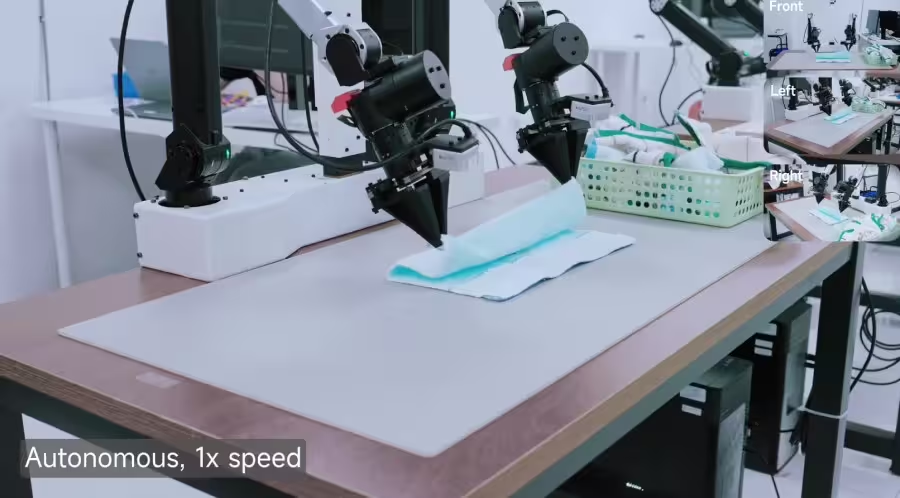
حولهای تاشده که انگار توسط دستی دقیق و مراقب مرتب شده بود. بلوکهایی که با دستهایی پایدار بازشدهاند. شاید اینها دستاوردهایی کوچک بهنظر برسند، اما گویا هستند. مدل جدید شیائومی، Robotics-0، محصولی چشمگیر برای مصرفکننده نیست؛ بلکه تلاشی است برای آموزش ماشینها تا چطور ببینند، بفهمند و با ظرافتی که معمولا به شهود انسانی نسبت میدهیم حرکت کنند.
در هستهٔ Robotics-0 تلاش میشود حلقهٔ اساسی هر ربات توانمند بسته شود: ادراک، تصمیمگیری و اجرا. شرکت این مجموعه را «هوش فیزیکی» مینامد — عبارتی کوتاه که پشت آن مجموعهای از مسائل دشوار پنهان است. چگونه میتوان سیستمی را همزمان در استدلال زبانی و تصویری تیز نگه داشت و در عین حال آن را برای حرکات میلیمتری آموزش داد؟ پاسخ شیائومی معماریای است که تفکر را از حرکت جدا میکند.
معماری و جداسازی وظایف
یکی از سمتها مدل زبان-تصویری (Visual Language Model) است — همان نقش مترجم برای ربات. این بخش جریانهای دوربین با وضوح بالا و دستورهای انسانی، حتی آنهایی که مبهماند («لطفا حوله را تا کن») را پردازش میکند. وظایفش شامل تشخیص اشیاء، نسبتهای فضایی، پرسش و پاسخ تصویری و نوعی استدلال مبتنی بر رعایت قواعد عمومی است که پیکسلها را به وظایف عملی تبدیل میکند. سمت دیگر «کارشناسِ عمل» (Action Expert) است: یک Diffusion Transformer که هدفش تولید یک فرمان موتوری منفرد نیست، بلکه خلق یک «بخش عمل» (Action Chunk) است — توالی کوتاهی از حرکات هماهنگ. در عمل این تقسیمبندی به انتقالهای نرمتر و اصلاحات کمترِ تند منجر میشود.
مدل زبان-تصویری
مدل زبان-تصویری در Robotics-0 به عنوان مغزِ بصری و معنایی عمل میکند. این مدل تصاویر با رزولوشن بالا، دوربینهای چندکاناله و ورودی متنی یا کلامی انسان را میگیرد و آنها را به نمایشهای داخلی (نمایههای چندرسانهای) تبدیل میکند که برای تصمیمگیریها قابلفهماند. کارهایی که این مدل انجام میدهد عبارتند از:
- تشخیص و طبقهبندی اشیاء (object detection) و تعیین موقعیتهای سهبعدی نسبی.
- تحلیل روابط فضایی میان اشیاء برای برنامهریزی تعامل (مثلاً لبهٔ حوله کجاست و از کجا باید گرفت).
- پاسخدهی به پرسشهای تصویری (Visual Q&A) و استخراج پیامدهای عملی از دستورهای نادرست یا مبهم.
- نگهداری تواناییهای استدلالیِ زبان و تصویر بدون افتِ بیشازحد زمانی که قرار است عمل را هدایت کند.
کارشناسِ عمل (Action Expert)
در سوی دیگر، Diffusion Transformer نقش ترجمهٔ نمایشهای داخلی به توالیهای حرکت را برعهده دارد. بهجای تولید یک دستور موتوری تکمرحلهای، این ماژول خروجیهایی چند-مرحلهای تولید میکند که هر کدام بهعنوان یک «بخش عمل» عمل میکند— یک توالی هماهنگ، هموار و قابل اجرا. مزایای این رویکرد در عمل شامل موارد زیر است:
- کاهش جهشها و اصلاحات تند (jerky corrections) بهخاطر تولید حرکتهای پیوسته.
- قابلیت تولید چندین مسیر پیشنهادی با احتمالات مختلف و سپس انتخاب یا ترکیب آنها بر اساس شرایط واقعی.
- استفاده از فرایندهای انتشار/ناویززدایی (diffusion denoising) برای تبدیل حدسهای نامطمئن به فرمانهای موتوریِ قابلاجرا.

معماری Mixture-of-Transformers و مزایای آن
این تفکیک وظایف در یک معماری شناختهشده بهنام Mixture-of-Transformers انجام میشود. بهجای تحمیل همهٔ مسئولیتها به یک مدل یکپارچه و بزرگ، کارها بین چندین ترنسفورمر تقسیم میشود. این انتخاب مهندسی مزایای مهمی دارد. یکی از مشکلات شناختهشده در پیوند بین «بینایی-زبان» و «کنترل» این است که وقتی یک مدل بینایی-زبانی برای عمل آموزش میبیند، معمولاً مقداری از لبهٔ استدلالی خود را از دست میدهد. شیائومی این مشکل را با آموزش مشترک روی دادههای چندرسانهای و مسیرهای عمل (action trajectories) حل میکند تا مدل بتواند همزمان سرش را در استدلال حفظ کند و دستهایش را حرکت دهد.
همآموزی (Co-training) و نگهداری تواناییها
روش همآموزی به معنای استفادهٔ همزمان از دادههای تصویری، زبانی و دادههای گردش و مسیرهای حرکت است. این رویکرد اطمینان میدهد که نمایههای داخلی مدلِ بینایی-زبانی با فضای عملِ مدل کارشناس سازگار باقی میمانند. بدین ترتیب مدل بینایی همچنان تواناییهای استدلالی و تفسیری خود را نگه میدارد، در حالی که مدل عمل یاد میگیرد چگونه خروجیهای آن نمایهها را به حرکات دقیق تبدیل کند.
فرآیند آموزش و مراحل یادگیری
آموزش در Robotics-0 به صورت مرحلهای انجام میپذیرد. مراحل کلیدی شامل موارد زیر است:
- مرحلهٔ پیشنهاد عمل (Action Proposal): مدل بینایی هنگام مشاهده یک تصویر توزیعهایی روی اعمال محتمل پیشبینی میکند. این کار نمایهسازیِ داخلیِ بین دیدن و انجام را همتراز میسازد.
- قفلکردن بخش بینایی: پس از همآموزی اولیه، بخش بینایی «فریز» میشود تا تواناییهای دیداری و استدلالی آن حفظ شود و کمتر بخشی از آن دچار تغییرات ناخواسته شود.
- آموزش Diffusion Transformer: در این مرحله، ترنسفورمر مبتنی بر انتشار برای «نویززدایی» توالیهای عملی آموزش میبیند—یعنی حدسهای نویزی را به حرکات قابل اجرا تبدیل میکند—که در این فرآیند از ویژگیهای کلید-مقدار (key-value features) هدایت میشود تا بهجای توکنهای گسستهٔ زبانی حرکتها را معنی کند.
رویکرد استفاده از ویژگیهای key-value به جای توکنهای زبانیِ گسسته کمک میکند تا ارتباط میان پردازش بصری و کنترل حرکتی دقیقتر و پیوستهتر برقرار شود. این روش برای مسائل رباتیکِ برد بلند (long-horizon) که نیاز به برنامهریزی مرحلهبهمرحله دارند، بسیار مناسب است.
مسائل عملی در رباتهای واقعی و راهکارها
رباتهای واقعی اصطلاحاً اصطکاکهای عملی را آشکار میکنند. یکی از مهمترین آنها، تاخیر زمانی (latency) است. اگر مدل برای فکرکردن مکث کند، ربات ممکن است یخ بزند یا تلوتلو بخورد که میتواند به شکستِ وظیفه یا آسیب فیزیکی منجر شود. شیائومی برای مقابله با این مشکل چندین راهکار مهندسی را بهکار گرفته است:
- استنتاج ناهمزمان (asynchronous inference): محاسبه و سختافزار تا حدی مستقل اجرا میشوند تا حرکت حتی هنگامی که مدل هنوز در حال محاسبه است، پیوسته بماند.
- بازخور به پیشبینیهای پیشین: آنها اقدامات پیشبینیشدهٔ قبلی را به سیستم بازمیگردانند — که به آن «پیشوند عمل پاک» (Clean Action Prefix) میگویند — تا تکانها کاهش یابد و مومنتوم حفظ شود.
- ماسک توجه بهشکل «لامبدا» (Λ): این ماسک توجه را به سمت سرنخهای بصری جاری سوق میدهد و تاریخچهٔ کهنه را کماهمیتتر میکند، که این امر پاسخگویی به تغییرات ناگهانی را بهبود میبخشد.
این روشها در جمع باعث میشود که سامانه در مواجهه با تاخیرهای پردازشی و تغییرات محیطی مقاومتر باشد. ترکیب استنتاج ناهمزمان با مکانیزمهای پیشبینی و فیدبک، کلید حفظ پویایی و ایمنی حرکتی در پلتفرمهای دنیای واقعی است.
آزمونها، بنچمارکها و نتایج عملی
بنچمارکها بخشی از داستان را روایت میکنند. شیائومی گزارش داده که در شبیهسازیها و محیطهای مرسوم، در مجموعههایی مانند LIBERO، CALVIN و SimplerEnv به نتایج برتر دست یافته است و عملکردی بهتر از حدود 30 سیستم همتای دیگر نشان داده است. اما اعداد تنها معیار نیستند؛ آزمایشهای دنیای واقعی اهمیت ویژهای دارند.
بر روی یک پلتفرم دو-بازویی (dual-arm)، Robotics-0 توانست وظایف در افق طولانی مانند تا زدن حوله و باز کردن قطعات بلوکها را با هماهنگی چشم-دستِ پیوسته انجام دهد. نکات فنی مشهود عبارت بودند از:
- توانایی کار با اشیای سخت و نرم: مدل نشان داد که میتواند هر دو نوع شیء را بدون حالت شکست آشکار مدیریت کند؛ هرچند مسائل لطیفتر مانند پردازش اجسام بسیار انعطافپذیر هنوز چالشبرانگیزند.
- هماهنگی بلندمدت: تقسیم وظایف بین دید و حرکت کمک کرد که ربات وظایف چندمرحلهای را بدون انحرافهای بزرگ دنبال کند.
- پایداری در حضور نویز حسی: استفاده از بخشهای انتشار و ماسکهای توجه مناسب، باعث شد تا اثر نویز دوربین یا سنسور کمتر به خطاهای کنترل منجر شود.
متن باز و تأثیر بر شتاب پژوهش
نکتهٔ عملی مهم دیگر این است که شیائومی قرار است Robotics-0 را بهصورت متنباز عرضه کند. این حرکت برای سرعت پژوهش اهمیت دارد. وقتی تیمها میتوانند کد را بررسی کنند، آزمایشها را تکرار کنند و روی کار همدیگر بسازند، پیشرفت با شتاب بالاتری رخ میدهد. انتظار میرود که مقالات پیروی، فورکها و تکرارهای سریع با استفاده از ایدههای VLA (بینایی-زبان-عمل) روی سختافزارهای مختلف ظهور کند.
متنباز شدن همچنین به ایجاد و استانداردسازی دادههای آموزشی و معیارهای ارزیابی کمک میکند. پژوهشگران میتوانند مجموعهدادههای جدیدی برای تعامل با اشیای نرم، حسگری لمسی یا همکاری چندرباتی فراهم آورند و این اکوسیستم را بهسمت راهحلهای کاربردیتر سوق دهند.
محدودیتها و چالشهای باز
Robotics-0 همهٔ مشکلات را حل نمیکند. برخی از چالشهای باز عبارتند از:
- دستورزی اشیای نرم (soft-object manipulation): تعامل پایدار با پارچهها، سیمها و اشیای بسیار انعطافپذیر هنوز مشکلساز است و نیاز به حسگری بیشتر و الگوریتمهای مدلسازی فیزیکی دقیقتر دارد.
- تعمیمپذیری به محیطهای کاملاً متفاوت: انتقال از یک میز استاندارد آزمایشگاهی به یک آشپزخانه شلوغ یا یک محیط خارجی پر متغیر، هنوز چالشی بزرگ است.
- خودگردانی کامل: رسیدن به سطحی که ربات بتواند بدون نظارت انسانی و با ایمنی کامل در محیطهای خانگی یا صنعتی عمل کند، هنوز به الگوریتمها و تستهای ایمنی بیشتری نیاز دارد.
اما آنچه مدل نشان میدهد یک جهتگیری عملی است: حفظ نزدیکی میان ادراک و عمل بدون اینکه یکی دیگری را مصرف کند. این مسئله یادآور این است که پیشرفت در رباتیک ممکن است به اندازهٔ تغییر اندازهٔ مدلها، به انتخابهای معماری هوشمندانه وابسته باشد.
تحلیل فنی و نکات تخصصی
از منظر فنی، ترکیب ترنسفورمرهای انتشار (diffusion transformers) با یک مدل بینایی-زبانی چندرسانهای، چندین نکتهٔ کلیدی را مطرح میکند:
- نمایشهای کلید-مقدار (key-value features) به عنوان رابط: استفاده از این نمایشها بهجای توکنهای زبانی سطح بالا، به همگرا نگه داشتن فضای نمایشی بین بینایی و کنترل کمک میکند.
- تولید بخشهای عمل به صورت توالی: بخشبندی توالیهای حرکتی باعث میشود که خطای تجمعی کمتر شود و امکان بازگشت سریع به قوانین امنیتی فراهم گردد.
- آموزش مبتنی بر مسیر و دادهٔ چندحسی: جمعآوری دادههای واقعی از مسیرهای حرکت و ترکیب آنها با دادههای شبیهسازی شده، روش مؤثری برای بهبود تعمیمپذیری است.
برای توسعهدهندگان و مهندسان رباتیک، این نکات بهعنوان راهنماییهای عملی برای طراحی سیستمهای عملگرا و قابلاعتماد مفید هستند. از منظر پژوهشی نیز، این معماری نشان میدهد که چگونه میتوان اجزای تخصصی را ترکیب کرد تا به عملکردهای پیچیده در دنیای واقعی رسید.
چشمانداز و پیامدهای آتی
اگر به این فکر میکنید که رباتها در آینده کجا حرکت خواهند کرد، باید منتظر باشید که چگونه این مدل خارج از آزمایشگاههای شیائومی عمل میکند و چه بخشهایی از آن توسط جامعهٔ پژوهشی نگه داشته و بهبود مییابد. برخی جهتگیریهای ممکن عبارتند از:
- سفارشیسازی برای سختافزارهای مختلف: همان ایدهٔ VLA میتواند روی بازوهای رباتیک مختلف، رباتهای چرخدار یا حتی هواپیماهای بدون سرنشین (پهپادها) اعمال شود.
- ادغام حسگرهای لمسی و نیرویی: برای دستورزی پیشرفتهٔ اشیای نرم، ترکیب دادههای لمسی با بینایی حیاتی است.
- توسعهٔ استانداردهای بنچمارک و مجموعهدادهٔ مشترک: متنباز بودن کمک میکند تا معیارهای مشترکی برای مقایسه و تکرار نتایج پدید آید.
نتیجهگیری
Robotics-0 لزوماً همهٔ مشکلات رباتیک را حل نمیکند، اما جهتگیریِ عملی و معماریِ جداشوندهٔ آن راهی ملموس برای افزایش هماهنگی میان ادراک و عمل ارائه میدهد. وقتی یک بات خانگی حولهٔ شما را تا میزند، ممکن است ردپای Robotics-0 را در هر تاِ نرم ببینید: تصمیمگیری بصری دقیق، برنامهریزی حرکتِ هماهنگ و اجرا با کمترین تکان و بیشترین ایمنی.
در نهایت، پیشرفت در رباتیک نه فقط از افزایش اندازهٔ مدلها، که از انتخابهای معماری هوشمند و تطبیقپذیریِ مهندسی نشأت میگیرد. دنبال کنید که جامعه چه بخشهایی را نگه میدارد، چه بهبودهایی پیشنهاد میدهد و چگونه ایدههای بینایی-زبان-عمل در سختافزار و کاربردهای واقعی گسترش مییابند.

نظر بگذارید
نظرات
هنوز نظری ثبت نشده. اولین نفر باشید.