

8 دقیقه
ادعا، واکنش و واقعیت اولیه
یک آمار ویروسی — «هر پرسش در ChatGPT معادل مصرف ۶۴ لیتر آب است» — آنقدر تکرار شده که شبیه یک حقیقت مسلم بهنظر میرسد. اما این ادعا دقیق نیست. سم آلتمن، مدیرعامل OpenAI، در رویدادی که توسط The Indian Express در هند برگزار شد، به شدت با این عدد مخالفت کرد و آن ادعاها درباره مصرف آب را «بیپایه» و گمراهکننده خواند.
نکته کوتاه و روشن این است که روایت قدیمی درباره مصرف عظیم آب از زمانی سرچشمه گرفت که برخی از مراکز داده برای خنکسازی از روش تبخیری (evaporative cooling) استفاده میکردند. این روش واقعاً آب مصرف میکرد، اما در بسیاری از مراکز دادهی مدرن تا حد زیادی کنار گذاشته شده است. آلتمن توضیح داد که اعداد منتشرشده در فضای مجازی تغییرات زیرساختی و روشهای نوین خنکسازی را نادیده میگیرند و تصویر ناقصی از میزان واقعی مصرف آب سیستمهایی مانند ChatGPT ارائه میدهند.
تکنیکهای خنکسازی و تاریخچه مصرف آب
برای فهم بهتر، لازم است تفاوت بین روشهای خنکسازی را بشناسیم. در گذشته برخی مراکز داده به خنککنندههای تبخیری متکی بودند که در فصلهای گرم و در مناطقی با آب فراوان، مصرف نسبتاً بالایی از آب داشتند. اما مراکز دادهی امروزی از ترکیبی از راهکارهای کارآمدتر استفاده میکنند: سیستمهای خنککننده هوایی پیشرفته، خنکسازی مایع با بازده بالا (direct-to-chip liquid cooling)، بازیابی حرارت، و طراحیهای مبتنی بر بهینهسازی هوا جریان (airflow) که مصرف آب را به شدت کاهش میدهند.
در عمل، جایگزینی تبخیر با سیستمهای مبتنی بر هوا یا مایع، و همچنین استفاده از الگوریتمهای مدیریت بار و تهویه هوشمند، باعث شده تا وابستگی به آب در بسیاری از مراکز داده کم یا حذف شود. علاوه بر این، محل قرارگیری مراکز داده — مانند انتخاب مناطق سردسیر یا مناطقی با دسترسی به انرژی پاک — تأثیر مستقیم بر نیازهای خنکسازی و در نتیجه مصرف آب دارد.
انواع سیستمهای خنکسازی و میزان مصرف آب
برای دستهبندی کلی میتوان گفت:
- خنکسازی تبخیری (Evaporative): مصرف آب قابل توجه در بعضی طراحیها، اما با راندمان مناسب در مناطق خاص.
- خنکسازی هوایی (Air cooling): معمولاً مصرف آب کم یا صفر، بهویژه در دیتاسنترهای مدرن با طراحی بهینه هوا.
- خنکسازی مایع (Liquid cooling): مصرف آب متفاوت است ولی بازده گرمایی بالاتری دارد و میتواند در استفاده کلی برق و منابع صرفهجویی کند.
- بازیابی و استفاده مجدد آب: برخی مراکز داده سیستمهای بازیافت آب یا استفاده از منابع غیرشرب را پیاده میکنند تا مصرف آب تازه کاهش یابد.
مصرف انرژی، مقیاس و نگرانیهای زیستمحیطی
آیا این بدان معناست که هیچ نگرانی زیستمحیطی وجود ندارد؟ قطعاً نه. آلتمن پذیرفت که مصرف انرژی یک نگرانی جدی و رو به رشد است. مقیاس اهمیت دارد: یک پرسش ممکن است بخش کوچکی از یک کیلوواتساعت انرژی مصرف کند؛ اما تقاضای جهانیِ ۲۴ ساعته و همیشگی برای خدمات هوش مصنوعی با سرعت زیادی در حال افزایش است. بار انرژی تجمعی — نه برآوردهای جداشده برای هر پرسش — معیاری است که باید قانونگذاران، اپراتورها و نهادهای سیاستگذاری را نگران کند.
مصرف انرژی شامل نه فقط برق موردنیاز برای پردازش مدلهای بزرگ، بلکه توان موردنیاز برای ذخیرهسازی، شبکه، خنکسازی و نگهداری زیرساخت است. بارهای پردازشی پیدرپی، آموزش مدلهای پایه (foundation models)، و بهروزرسانی مکرر مدلها همگی به افزایش مصرف انرژی منجر میشوند. از این رو مهم است که بحث از «مصرف به ازای هر پرسش» به «مصرف تجمعی و سیستمی» تغییر کند.
معیارهای مناسب برای سنجش تأثیر انرژی
چند معیار بهتر وجود دارد که میتوان برای ارزیابی زیستمحیطی استفاده کرد:
- مصرف انرژی کل سالانه (MWh) ناشی از عملیات هوش مصنوعی در یک سرویس یا شرکت خاص.
- شدت کربنی برق مصرفی (گرمادادن گازهای گلخانهای به ازای هر MWh) که تعیین میکند انرژی مصرفی تا چه حد آلاینده است.
- مصرف آب کل مرکز داده در سال، شامل منابع خنکسازی، و تفکیک منابع شرب و غیرشرب.
- بازده انرژی مدل (Energy per inference) در کنار نرخ استفاده (utilization rate) سرورها و خوشهها.
تصویر مقایسهای: انرژی انسان در برابر انرژی هوش مصنوعی
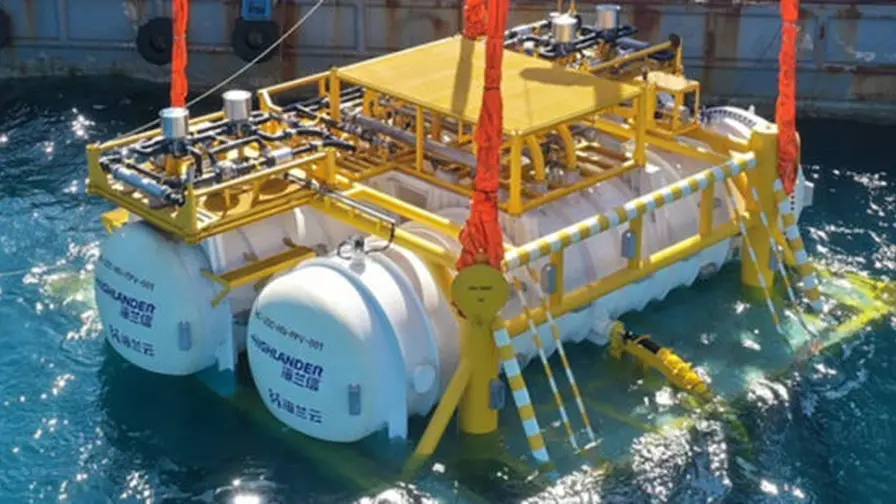
سپس آلتمن مقایسهای تحریکآمیز مطرح کرد: چگونه میتوان هزینه انرژی «هوشمندی» را سنجید؟ انسانها دههها صرف یادگیری میکنند. آلتمن اشاره کرد که یک فرد برای رسیدن به توانایی شناختی بالغ، حدوداً معادل بیست سال غذا و انرژی متابولیک مصرف میکند. او همچنین شناخت انسان را محصول تلاشی تکاملی دانست که دربارهٔ ۱۰۰ میلیارد نفر (برآوردی از تعداد افرادی که در طول تاریخ زیستهاند) گسترده شده است — فرایندی کند، پراکنده و پرهزینه از منظر منابع.
نتیجهگیری آلتمن این بود که اگر میخواهیم مقایسهای عادلانه داشته باشیم، باید انرژی لازم برای پاسخدهی یک مدل آموزشدیده به یک پرسش را در برابر انرژیای که یک انسان برای پاسخ به همان پرسش مصرف میکند بسنجیم. به این معیار، او پیشنهاد داد که هوش مصنوعی میتواند کارآمدتر باشد — اما فقط در صورتی که انرژی مصرفی آن کمکربن باشد.
چرا این مقایسه پیچیده است؟
چند عامل پیچیدگی ایجاد میکنند:
- تعریف «پرسش» و «پاسخ»: پرسشی ساده متفاوت از یک مسئله تحلیلی پیچیده انرژی مصرف میکند.
- شاملسازی کل چرخه عمر: باید انرژی آموزش اولیه مدل، استقرار، نگهداری و استنتاج (inference) را در نظر گرفت.
- پایگاه انرژی: اگر برق مصرفی از منابع تجدیدپذیر تأمین شود، شدت زیستمحیطی هر عملیات کاهش مییابد.
راهحلها: انرژی پاک و معماری زیرساختی
پس راهحل چیست؟ توسعه سریعتر انرژی پاک. آلتمن از تغییر شتابدار به سوی نیروگاههای هستهای، بادی و خورشیدی حمایت کرد تا جهان بتواند تقاضای رو به رشد برق را بدون تشدید بحران اقلیمی پاسخ دهد. او استدلال کرد که این یک گزینه اضافی نیست، بلکه ستون فقرات توسعه مسئولانه هوش مصنوعی است.
علاوه بر تولید انرژی پاک، رویکردهای زیر میتواند تأثیر را کاهش دهد:
- مکانیابی هوشمند مراکز داده نزدیک منابع انرژی پاک یا در مناطق سردسیر.
- طراحی مراکز داده با قابلیت بازیابی گرما و استفاده ثانویه از حرارت تولیدی برای گرمایش محلی.
- پذیرش سختافزارهای کارآمدتر و معماریهای محاسباتی مانند شتابدهندههای اختصاصی که انرژی هر استنتاج را کاهش میدهند.
- بهکارگیری استراتژیهای نرمافزاری برای بهینهسازی بارها و کاهش پردازشهای غیرضروری.
سرمایهگذاری در زیرساخت و سیاستگذاری
برای این تغییرات، سرمایهگذاری در شبکه توزیع برق، ذخیرهسازی انرژی و مقررات حمایتی لازم است. دولتها میتوانند مشوقهایی برای استقرار مراکز داده در مناطقی با شبکه پاک فراهم کنند و استانداردهایی برای شفافیت و گزارشدهی میعّن نمایند تا اثرات زیستمحیطی بهتر قابل ردیابی باشند.
شفافیت، گزارشدهی و چارچوبهای قانونی
یک پیچیدگی دیگر این است که در حال حاضر الزام قانونی جهانی وجود ندارد که شرکتهای فناوری میزان دقیق و حسابرسیشدهٔ مصرف آب و انرژی خود را منتشر کنند. پژوهشگران مستقل تلاش میکنند با استفاده از برآوردهای غیرمستقیم تأثیرات را مدلسازی کنند، و در برخی مناطق مراکز داده به افزایش قیمت برق و فشار بر شبکههای توزیع منجر شدهاند.
گزارشدهی استانداردشده و حسابرسیشده میتواند از چند دیدگاه مفید باشد:
- افزایش شفافیت برای عموم و تصمیمگیرندگان دربارهٔ میزان واقعی مصرف منابع سنتی و تجدیدپذیر.
- توانمندسازی پژوهشگران مستقل برای مقایسهٔ واقعی بین ارائهدهندگان خدمات و فناوریها.
- ایجاد انگیزه برای سرمایهگذاری در فناوریهای کممصرف و انرژی پاک.
مؤلفههای یک چارچوب گزارشدهی موثر
چارچوب باید شامل موارد زیر باشد: اندازهگیری کل انرژی و آب مصرفی، تخصیص مصرف به فعالیتهای مشخص (آموزش، استنتاج، ذخیره)، شدت کربنی برق مصرفی، روشهای خنکسازی مورد استفاده، و بازههای زمانی حسابرسی مستقل. استانداردسازی این مؤلفهها به تحلیلی منصفانه و قابل ملاحظه کمک میکند.
انتقال گفتوگو از تیترهای جنجالی به مسائل واقعی
بحث و شفافیت همگام با استقرار فناوری رشد خواهند کرد. اما اگر ما در پی پایداری هوش مصنوعی هستیم، گفتگو باید از تیترهای حماسی و اخباری درباره «مصرف ۶۴ لیتر آب به ازای هر پرسش» فاصله بگیرد و به سوالات واقعی دربارهٔ برق پاک، سرمایهگذاری در زیرساخت، و گزارشدهی عمومی تبدیل شود.
تمرکز بر پیامدهای عملی و سیاستگذاری بهجای ارقام خارج از زمینه، راه را برای راهکارهای قابل اجرا هموار میکند. این شامل شناسایی نقاط بحرانی در زنجیره تأمین انرژی و اتخاذ سیاستهایی است که هم رشد فناوری و هم حفاظت منابع طبیعی را تضمین کند.
پیشنهادات عملی برای ذینفعان
چند پیشنهاد مشخص برای ذینفعان مختلف:
- شرکتهای فناوری: انتشار گزارشهای شفاف، سرمایهگذاری در انرژی تجدیدپذیر، و بهینهسازی نرمافزار و سختافزار برای کاهش شدت انرژی.
- قانونگذاران: تدوین استانداردهای گزارشدهی، ارائه مشوق برای مراکز داده کماثر، و حمایت از توسعه شبکههای پاک و ذخیرهسازی انرژی.
- پژوهشگران و جامعه مدنی: توسعه متدولوژیهای مستقل برای برآورد اثرات، و فشار برای انتشار دادههای پایه توسط شرکتها.
- کاربران و مشتریان: درک تفاوت بین معیارهای فردی و تجمعی و درخواست شفافیت و مسئولیتپذیری از ارائهدهندگان خدمات.
نتیجهگیری: تمرکز بر برق پاک و گزارشدهی معتبر
ادعای ساده و جذاب «۶۴ لیتر آب به ازای هر پرسش» تصویری سطحی و اغلب نادرست از یک مسأله پیچیده ارائه میدهد. واکنش آلتمن این بود که ارقام موجود در اینترنت شرایط کنونی زیرساختها و نوآوریهای خنکسازی را نادیده میگیرند. در عین حال، نگرانی دربارهٔ مصرف انرژی و اثرات زیستمحیطی هوش مصنوعی کاملاً معتبر است و باید در دستور کار سیاستگذاران و اپراتورها قرار گیرد.
راهحل در ترکیبی از توسعه سریع انرژی پاک، بهینهسازی زیرساختی، و شفافیت و گزارشدهی استاندارد شده نهفته است. اگر قصد توسعه هوش مصنوعی پایدار را داریم، باید از شعارها و تیترهای جنجالی عبور کنیم و به سیاستها، معیارها و سرمایهگذاریهایی بپردازیم که واقعاً تفاوت ایجاد میکنند.

نظر بگذارید
نظرات
هنوز نظری ثبت نشده. اولین نفر باشید.