

4 دقیقه
مرکزهای داده بهندرت یکشبه تغییر میکنند. اما وقتی این اتفاق میافتد، صدایش را میشود شنید. رکها متراکمتر میشوند. تأخیر کاهش مییابد. هزینهها دوباره چیده میشوند. انویدیا شرط بسته است که این تغییر بهزودی نام تازهای خواهد داشت: ورای.
انویدیا میگوید ورای حدود 1.8 برابر عملکرد تراشههای پیشرو x86 را ارائه میدهد. این ادعا تیتر اصلی است. اما سختافزار پشت آن، شروع گفتوگو است. ورای بخش CPU پلتفرم Vera Rubin است که یک پردازنده مبتنی بر ARM را با یک GPU روبین جفت میکند تا بارهای کاریای را پوشش دهد که به پهنای باند بسیار بالا و هماهنگی نزدیک بین CPU و GPU نیاز دارند.
چرا ورای نگاه به سرورهای هوش مصنوعی را تغییر میدهد
ورای بر پایه 88 هسته Olympus با فناوری Spatial Multithreading ساخته شده و در هر سوکت 176 رشته پردازشی ارائه میدهد. حافظه هم در اینجا موضوعی فرعی نیست: یک CPU میتواند تا 1.5 ترابایت LPDDR5X را پشتیبانی کند و پهنای باندی در حدود 1.2 ترابایت بر ثانیه فراهم آورد. برای استنتاج هوش مصنوعی و مدلهای عاملمحور که زمینه و وزنها را با سرعت مصرف میکنند، همین پهنای باند معیار بقاست.

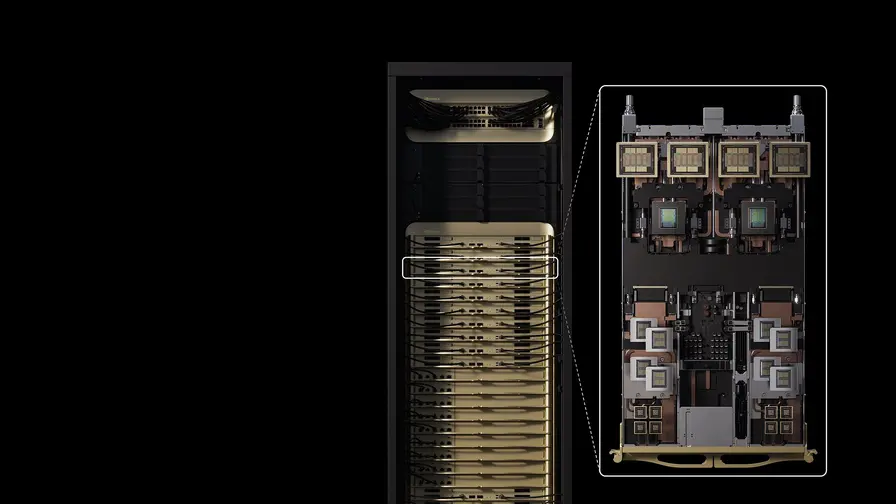
مقیاس را در نظر بگیرید. انویدیا یک Vera CPU Rack را نمایش داد که 256 CPU را در یک شاسی جا میدهد. این یعنی 22,528 هسته و 45,056 رشته پردازشی. چنین تراکمی همان چیزی است که ارائهدهندگان ابری به آن نیاز دارند، وقتی میخواهند مدلهای بزرگ را از جزایر گرانقیمت مبتنی بر GPU خارج کنند و به معماریهای انعطافپذیرتر و متمرکز بر CPU منتقل کنند.
ورای همچنین بهخوبی با GPUهای روبین کار میکند. پیکربندی NVL72، 36 CPU ورای را با 72 GPU روبین جفت میکند و انویدیا از اتصال NVLink-C2C با پهنای باند 1.8 ترابایت بر ثانیه بین آنها خبر میدهد. هدف، جایگزینی GPUها نیست، بلکه بازطراحی رابطه میزبان و شتابدهنده است تا داده سریعتر جابهجا شود و نرمافزار با گلوگاههای کمتری روبهرو باشد.
کاربردها آشنا هستند اما رو به رشدند: هوش مصنوعی عاملمحور، یادگیری تقویتی، تحلیلهای سنگین و استنتاج در مقیاس بزرگ. ورای میتواند هم بهعنوان یک گره محاسباتی مستقل برای این وظایف عمل کند و هم بهعنوان میزبانِ تغذیهکننده و هماهنگکننده GPUهای روبین.

پذیرش این پلتفرم همین حالا هم آغاز شده است. Anthropic، OpenAI و SpaceXAI برای بارهای کاری مدلهای خود به این پلتفرم متعهد شدهاند و ارائهدهندگان هایپراسکیلر مانند ByteDance، CoreWeave و Oracle Cloud Infrastructure نیز به آن پیوستهاند. در بخش سیستمها، Dell، HP، Lenovo و Supermicro سرورهای مبتنی بر ورای را عرضه خواهند کرد. تولیدکنندگان بزرگ از جمله Asus، Compal، Foxconn، Gigabyte، Pegatron، Quanta Cloud Technology، Wistron و Wiwynn نیز سختافزار مبتنی بر این تراشه را تولید میکنند.
حتی مشتریان غیرسنتی هم به این موضوع توجه نشان دادهاند. بورس اوراق بهادار نیویورک که روزانه حدود 1.1 تریلیون پیام پردازش میکند، در حال بررسی ورای همراه با شرکای Redpanda و HP است تا زیرساخت حساس به تأخیر خود را بازنگری کند. این سطح از توجه نشان میدهد که این پلتفرم فقط برای آموزش مدلها بررسی نمیشود، بلکه برای سامانههای بلادرنگ و پرتوانی هم در نظر گرفته شده است؛ سامانههایی که در آن هر میکروثانیه اهمیت دارد.
برای انویدیا، ورای ادامه همان راهبرد آشناست: آموختههای بهدستآمده از استقرارهای هوش مصنوعی مبتنی بر GPU را به طراحی CPU تعمیم دهد. این شرکت پیشتر کارهای هوش مصنوعی خود را در محصولاتی مانند RTX Spark ادغام کرده بود؛ محصولی که پردازندههای Grace و GPUهای Blackwell را همراه با حافظه LPDDR5X در مرکز توجه قرار داد. حالا گفتوگو از عملکرد GPU در یک گره، به تعادل و توان عملیاتی در سطح کل سیستم منتقل شده است.
آیا ورای میتواند x86 را در مرکز داده کنار بزند؟ نه به این زودی. اما این معماری دقیقاً روی نقاط درد بارهای کاری هوش مصنوعی تمرکز دارد: پهنای باند حافظه، تراکم رشتههای پردازشی و اتصال سریع میان CPU و GPU. برای مهندسان و معمارانی که با هزینه مدلها و توان عملیاتی دستوپنجه نرم میکنند، این یک شروع عملی و مهم است.

نظر بگذارید
نظرات (3)
واسه بارهای AI خب خیلی معنی داره، ولی کنار زدن x86 اینجوری یه شبه نمیشه... فعلا بیشتر شبیه شروع یه موج جدیده
اینکه CPU و GPU رو اینقدر نزدیک میکنن منطقیه، مخصوصا برای inference. ولی 1.8 برابر؟ باید دید تو دیتاسنتر واقعی هم همون میمونه یا نه
جالبه ولی یه کم بوی هیاهوی تبلیغاتی میده... اگه این پهنای باند واقعا تو عمل هم دربیاد، x86 حسابی تحت فشار میره.