

3 دقیقه
یک یافتهٔ شگفتانگیز از مطالعهٔ مشترک دانشگاه مریلند و مایکروسافت: زبان لهستانی از میان 25 زبان دیگر بهترین عملکرد را در پرامپتزدن به مدلهای بزرگ هوش مصنوعی نشان داد، در حالی که انگلیسی تنها در رتبهٔ ششم قرار گرفت.
چگونه پژوهشگران عملکرد زبانها را با هوش مصنوعی آزمایش کردند
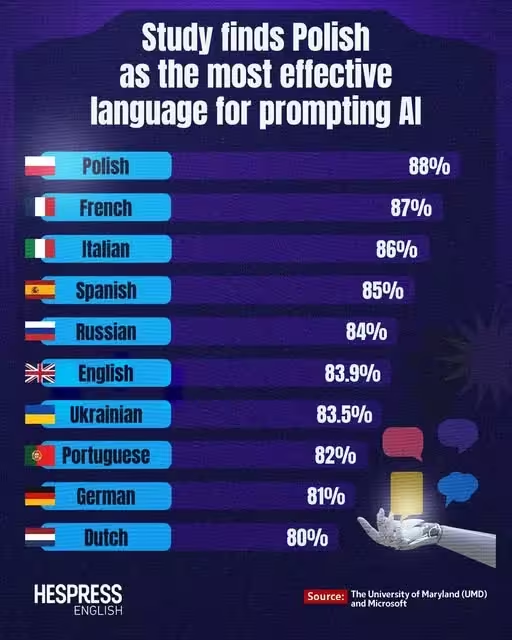
تیم تحقیقاتی پرامپتهای یکسانی را که به 26 زبان ترجمه شده بودند به چندین مدل زبانی بزرگ — از جمله مدلهای OpenAI، Google Gemini، Qwen، Llama و DeepSeek — داد و دقت انجام وظایف را اندازهگیری کرد. برخلاف انتظار، لهستانی در صدر قرار گرفت با میانگین دقت وظیفهٔ 88٪.
نویسندگان گزارش نتایج را «غیرمنتظره» خواندند و اشاره کردند که انگلیسی برندهٔ مطلق نبوده است. در ارزیابیهای متنهای بلندتر، انگلیسی در جایگاه ششم قرار گرفت در حالی که لهستانی پیشتاز بود. این مطالعه نشان میدهد انتخاب زبان میتواند کیفیت خروجی مدل را بهصورت معناداری تحت تأثیر قرار دهد.
بهترین زبانها برای پرامپتزدن به هوش مصنوعی — جدول ردهبندی مطالعه
در اینجا ده زبان برتر از مطالعه بر اساس میانگین دقت آورده شدهاند:
- لهستانی — 88%
- فرانسوی — 87%
- ایتالیایی — 86%
- اسپانیایی — 85%
- روسی — 84%
- انگلیسی — 83.9%
- اوکراینی — 83.5%
- پرتغالی — 82%
- آلمانی — 81%
- هلندی — 80%
چرا لهستانی ممکن است برای پرامپتها بهتر عمل کند؟
چند نظریه میتواند این نتیجهٔ برعکسانتظار را توضیح دهد. لهستانی از نظر مورفولوژیکی غنی است و قواعد هجی نسبتاً ثابتی دارد، که ممکن است منجر به تولید توکنهایی شود که با روشهای توکنسازی ترنسفورمرها هماهنگی بهتری دارند. این میتواند پرامپتها را برای مدل شفافتر کند حتی اگر نمونههای آموزشی لهستانی کمتر باشند.
عامل دیگری ابهام و شیوهٔ بیان است: برخی زبانها بهطور طبیعی نشانههای دستوری صریحتری را الزام میکنند و بدینترتیب احتمال تفسیر نادرست نیت توسط مدل کاهش مییابد. مطالعه همچنین نشان میدهد اینکه زبانی «برای انسان سخت» باشد لزوماً به معنای دشوار بودن آن برای مدلهای هوش مصنوعی نیست — مدلها میتوانند الگوهای ساختاری را مستقل از دشواری یادگیری برای انسانها یاد بگیرند.
در سوی دیگر، زبان چینی در این ارزیابی نزدیک به پایین فهرست (چهارم از آخر) قرار گرفت، که نشان میدهد تنها داشتن دادههای آموزشی فراوان تضمینکنندهٔ عملکرد بهتر پرامپت در همهٔ زبانها نیست.
پیامدها برای مهندسی پرامپت و هوش مصنوعی چندزبانه
پس توسعهدهندگان، پژوهشگران و مهندسان پرامپت چه نکاتی باید مدنظر قرار دهند؟
- فرض نکنید همیشه انگلیسی بهترین است: پرامپتها را در چند زبان آزمایش کنید — ممکن است خروجیهای دقیقتر یا مختصرتر را به زبانی غیرمنتظره دریافت کنید.
- تأثیرات مورفولوژی و توکنسازی را هنگام طراحی بنچمارکهای چندزبانه یا مجموعههای داده برای فاینتیون در نظر بگیرید.
- برای استقرار بینالمللی، رفتار مدل را در زبانهای هدف بهصورت مستقیم ارزیابی کنید و از تعمیم نتایج فقط از آزمایشهای انگلیسی خودداری نمایید.
دفتر ثبت اختراعات لهستان حتی در شبکههای اجتماعی نوشت که نتایج نشان میدهد لهستانی دقیقترین زبان برای هدایت هوش مصنوعی است و با طعنه افزود: ممکن است یادگیری لهستانی برای انسانها دشوار باشد، اما این محدودیت برای AI صادق نیست.
گام بعدی چیست؟
پژوهشگران میگویند این پایان کار نیست — لازم است تحقیقات بیشتری انجام شود تا بفهمیم چگونه توکنسازی، توزیع دادههای آموزشی و ساختارهای زبانی بر رفتار مدل تأثیر میگذارند. با اینهمه، این مطالعه جامعهٔ هوش مصنوعی را به بازنگری در فرضیات و انجام آزمایشهای گستردهتر هنگام بهینهسازی پرامپتها برای مدلهای چندزبانه ترغیب میکند. در عمل این به معنای آزمایش سیستماتیک زبانها، تحلیل تأثیر توکنها و گزارشدادن معیارهای دقیق دقت و پاسخدهی (precision, recall, accuracy) برای هر زبان خواهد بود که میتواند به بهبود مهندسی پرامپت و طراحی مجموعههای دادهٔ چندزبانه کمک کند.

نظر بگذارید
نظرات (3)
چرا اینقدر تفاوت بین زبان ها؟ آیا واقعاً به خاطر توکنسازی و مورفولوژی است یا چیز دیگه ای هم دخیل است؟
اینطور که پیدا سره میگه زبان انتخابی توی پرامپتها خیلی مهمه و فقط دادههای آموزشی نیست.
وای این نتیجه واقعاً شگفتانگیزه! لهستانی از انگلیسی جلو میزنه تو پرامپت ها؟ امیدوارم توضیحات دلیل این اختلاف هم بیاد.