

14 دقیقه
چهار مدل مطرح. نه دستهبندی. یک قهرمان کلی. این یک معیار آزمایشگاهی با جدولرتبهبندیهای مرموز نیست؛ یک مقایسه کاربردی انتها-به-انتها است که از تکالیفی ساخته شده که واقعاً برای کاربران اهمیت دارد: حل مسائل واقعی زیر فشار زمان، تولید تصویر و ویدیو، بررسی واقعیت بدون اتصال به اینترنت، تحلیل ورودیهای نامنظم، خلاقیت به درخواست، صحبت طبیعی و انجام پژوهشهای عمیق که در برابر بررسی مقاومت کنند. هر زیرکار از 0 تا 4 امتیازدهی شد و جمع نمرات را نگه داشتیم. در پایان یک قهرمان اعلام شد و مهمتر از آن، هر مدل را به کارهایی که در آنها بهترین است نگاشتیم.
پاسخ کوتاه اول: Gemini با 46 امتیاز برنده کلی است. ChatGPT با 39 امتیاز نزدیک در مقام دوم ایستاد. Grok با 35 سوم شد. DeepSeek با 17 عقب ماند. این به این معنی نیست که همیشه باید برنده را انتخاب کنید. دستههای مختلف نقاط قوت متفاوتی را برمیگزینند و انتخاب درست بستگی به کاری دارد که میخواهید انجام دهید. این بررسی دقیقاً نشان میدهد هر مدل در چه زمینهای میدرخشد و کجا دستوپا میزند، همراه با نمونههای مشخص و امتیازدهی شفاف.
How We Tested
Models compared: ChatGPT, Gemini, Grok, DeepSeek.
Categories: nine in total. Some include multiple rounds or prompts.
Scoring: each round is graded 0–4. Where the source comparison specified explicit scores or rank orders, we used those; otherwise we followed the same rules and rubric.
Constraints: when a round forbid internet access, we honored that constraint. Where a capability does not exist (for example, image or video generation in DeepSeek), the model scores zero for that round.
Speed: recorded descriptively, not scored as its own category, to keep totals aligned with the original contest.
هدف ما ساختن سوالات پیچیده یا فریبآمیز نبود؛ قصد این بود که رفتار مدلها در شرایط واقعی را محک بزنیم، از جمله حالتهای شکست متداول مثل اختراع جزئیات در تحلیل تصویر یا محاسبات بودجهای سطحی که سناریو را نادیده میگیرند.
Category 1: Problem Solving
دو چالش واقعی. هر کدام جداگانه امتیاز گرفتند و سپس جمع شدند.
Round 1: You have 10 dollars, a dead phone, no map, and 45 minutes to reach a central train station in a foreign city. Give a five-step plan.
Speed: DeepSeek در 7 ثانیه پاسخ داد، Grok در 11، Gemini در 21 و ChatGPT در 62 ثانیه.
Quality: هر چهار مدل برنامههای پنج مرحلهای ساختاریافته و قابل اجرا ارائه دادند.
Peer review twist: سپس تمام چهار پاسخ را به هر مدل نشان دادیم و از آنها خواستیم بهترین را انتخاب کنند. هر مدل مستقلانه پاسخ ChatGPT را برگزید.
Scores, Round 1
ChatGPT 4, Gemini 3, Grok 2, DeepSeek 1.
Round 2: You have 400 dollars after rent to cover groceries, transport, and internet. Groceries cost 50 per week, transport 80 per month, internet 60 per month. You want to attend a 200 dollar event next month. How do you budget?
این یک تلهٔ استدلالی بود. ChatGPT، Grok و DeepSeek تصمیم گرفتند همین حالا فقط 60 دلار کنار بگذارند و «ماه بعد بیشتر پسانداز کنند»، که دیگر دیر است. Gemini تنها مدلی بود که فوراً برنامه را اصلاح کرد: هزینه غذا را با خرید تخفیفی و برنامهریزی وعدهها به میزان 15 دلار در هفته کاهش داد تا کسری همین ماه پوشش داده شود.
Scores, Round 2
Gemini 4, ChatGPT 3, Grok 3, DeepSeek 2.
Problem Solving Totals
| Model | Round 1 | Round 2 | Total |
|---|---|---|---|
| ChatGPT | 4 | 3 | 7 |
| Gemini | 3 | 4 | 7 |
| Grok | 2 | 3 | 5 |
| DeepSeek | 1 | 2 | 3 |
تفسیر: ChatGPT برنامهریزی گامبهگام قوی نشان داد و در رایگیری همتیمیها برنده شد؛ Gemini در سازگار کردن سناریو زیر محدودیت بهتر عمل کرد. هر دو در مجموع برای مقام اول برابر شدند.
Category 2: Image Generation
دو درخواست تصویر. DeepSeek توانایی تولید تصویر ندارد و بهصورت پیشفرض صفر امتیاز میگیرد.
Prompt 1: Photoreal Mona Lisa as a frustrated street protester in Times Square, holding a cardboard sign that reads “Make Florence great again” in bold red letters.
Grok: سریعتر است، اما واضحاً مصنوعی به نظر میرسد. سوژه اشتباه به نظر میآید، حتی با دستهای اضافی.

Gemini: ترکیب و محیط خوب است؛ اما سوژه همچنان سه دست دارد.
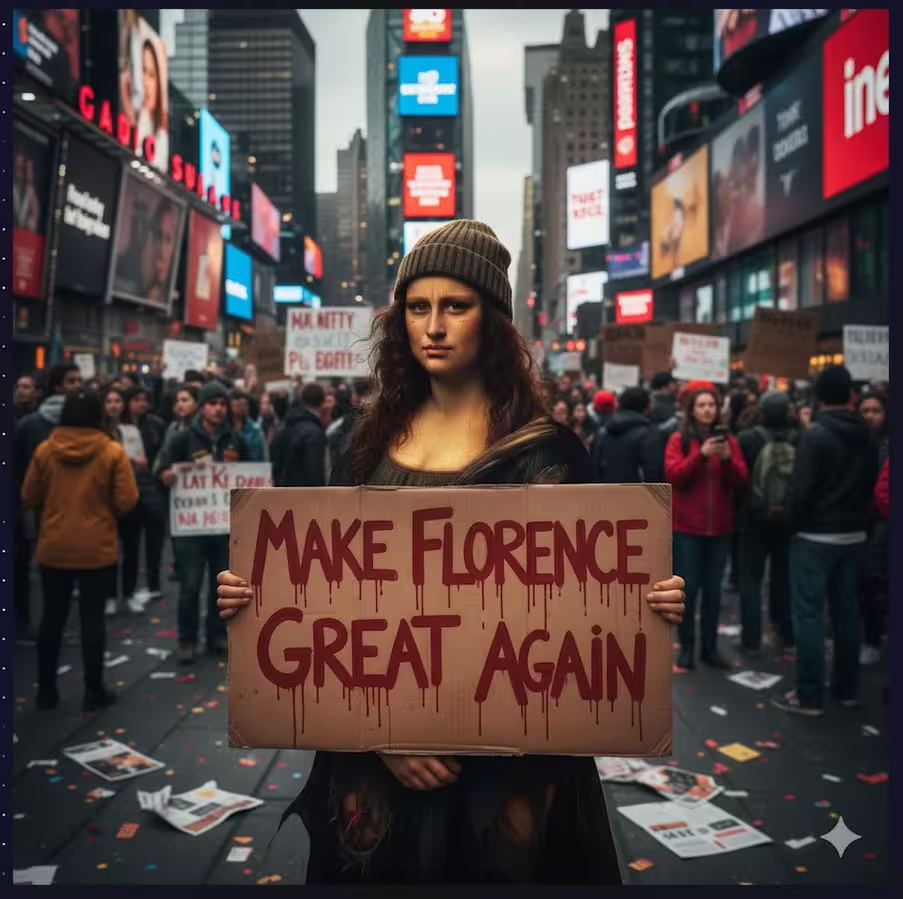
ChatGPT: طبیعیترین سوژه با پسزمینهٔ قابلقبول تایمز اسکوئر؛ تابلو و ژست هم با شرح تطابق دارند.

Scores
ChatGPT 4, Gemini 3, Grok 1, DeepSeek 0.
Prompt 2: Photoreal classroom with a hippie-style teacher beside a chalkboard showing the full alphabet in chalk, letters decreasing in size.
Grok: فضای کلاس و دستخط واقعی به نظر میرسند، اما الفبا نادرست و ناقص است.
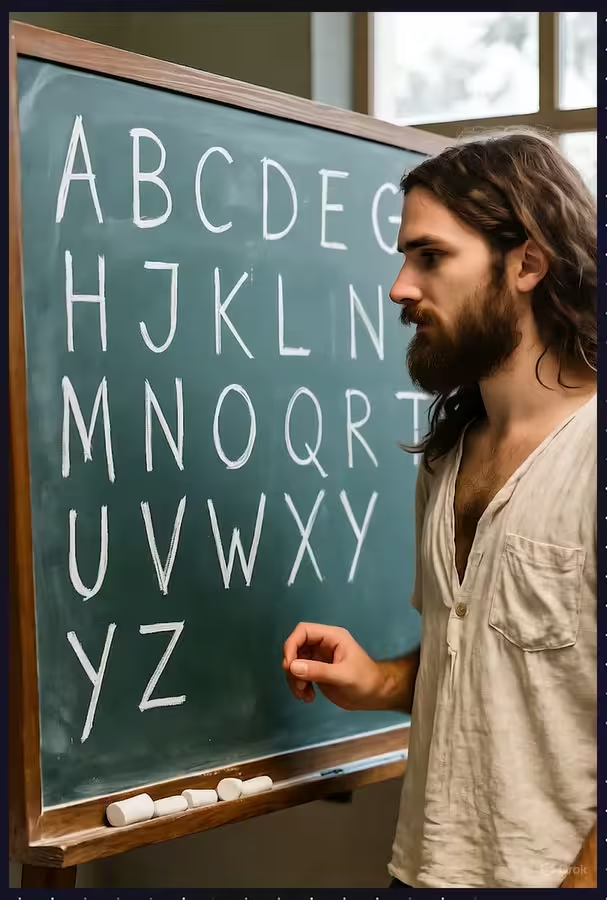
Gemini: از نظر زیباییشناسی دلپذیر است، اما بیشتر سبکشده تا فوتورئال؛ حروف بیش از حد ایدهآل و اضافیاند.

ChatGPT: از نظر کلی قانعکنندهترین است؛ نورپردازی، جزئیات کلاس و معلم قابلباورند. دستخط ممکن است بیش از حد کامل باشد.

در مسابقهٔ اصلی، امتیاز بالاتر برای این دور تا 3 محدود شده بود.
Scores
ChatGPT 3, Gemini 2, Grok 2, DeepSeek 0.
Image Generation Totals
| Model | P1 | P2 | Total |
|---|---|---|---|
| ChatGPT | 4 | 3 | 7 |
| Gemini | 3 | 2 | 5 |
| Grok | 1 | 2 | 4 |
| DeepSeek | 0 | 0 | 0 |
تفسیر: ChatGPT برای فرامین فوتورئال قابلاعتمادترین است. Gemini معمولاً نزدیک میشود، در حالی که Grok در آناتومی ظریف و تولید متن روی تصویر ضعیفتر عمل میکند.
Category 3: Fact-Checking Without Internet
سه سوال چندگزینهای. امتیازهای اطمینان ثبت شد اما روی معیار نمرهدهی اثر نداشتند.
Q1: In 2018, about how many chickens were killed for meat production?
گزینهها: 690 میلیون، 6.9 میلیارد، 69 میلیارد، 690 میلیارد.
پاسخ صحیح: 69 میلیارد.
Grok بهصورت مستقیم 69 میلیارد را پاسخ داد.
ChatGPT بازهای ارائه داد که رقم درست را در بر میگرفت.
Gemini و DeepSeek ارقام را کمی کمتر و نزدیک به 65 میلیارد گزارش کردند.
Scores
Grok 4, ChatGPT 3, Gemini 1, DeepSeek 1.
Q2: As of 2020, approximately how much annual income puts you in the richest 1 percent globally?
گزینهها: 200k، 75k، 35k، 15k.
پاسخ صحیح: 35k.
Gemini عدد 34k را ذکر کرد.
ChatGPT عدد 200k را داد، Grok 60k و DeepSeek 75–85k را گفت.
Scores
Gemini 4, others 0.
Q3: In 2019, what proportion of U.S. electricity came from fossil fuels?
گزینهها: 83%، 63%، 43%، 23%.
پاسخ صحیح: 63%.
Gemini دقیقاً 63% را زد.
ChatGPT 63–65%، Grok 62% و DeepSeek 60–65% اعلام کردند.
Scores
Gemini 4, ChatGPT 3, Grok 3, DeepSeek 3.
Fact-Checking Totals
| Model | Q1 | Q2 | Q3 | Total |
|---|---|---|---|---|
| ChatGPT | 3 | 0 | 3 | 6 |
| Gemini | 1 | 4 | 4 | 9 |
| Grok | 4 | 0 | 3 | 7 |
| DeepSeek | 1 | 0 | 3 | 4 |
تفسیر: Gemini در دقت و سازگاری پیروز است. Grok سوال اول را دقیق زد اما در آستانهٔ درآمدی خیلی فاصله گرفت. محدودههای ChatGPT کمککنندهاند، اما دقت عددی اهمیت دارد.
Category 4: Multimodal Analysis
دو دور: یک عکس یخچال و یک صحنهٔ «کجا والدوست؟».

Round 1: What’s in the fridge, and propose three meals from those ingredients.
DeepSeek قادر به شناسایی اشیاء نیست و حذف شد.
ChatGPT سه قلم را از دست میدهد، چیز اضافی اختراع نمیکند و وعدههای غذایی معقولی متناسب با موجودی پیشنهاد میدهد.
Gemini هفت قلم را از دست میدهد و مرکباتی را که وجود ندارد اختراع میکند.
Grok سه قلم را از دست میدهد اما فهرست بلندی از اقلام افزودهٔ خیالی میسازد و سپس دستورهایی مینویسد که آن مواد شبحمانند را نیاز دارند.

Scores
ChatGPT 4, Gemini 3, Grok 2, DeepSeek 0.
Round 2: Find Waldo in a busy illustration.

هیچیک از مدلها والدو را درست پیدا نکردند. DeepSeek متن پراکنده را میخواند و جواب نامشخصی ارائه داد.
Scores
All 0.
Analysis Totals
| Model | Fridge | Waldo | Total |
|---|---|---|---|
| ChatGPT | 4 | 0 | 4 |
| Gemini | 3 | 0 | 3 |
| Grok | 2 | 0 | 2 |
| DeepSeek | 0 | 0 | 0 |
تفسیر: اختراع اشیاء (hallucination) برای سودمندی در دنیای واقعی کشنده است. ChatGPT از وسوسهٔ اختراع اجتناب کرد و همین خود برندهٔ این دور شد.
Category 5: Video Generation
دو صحنهٔ کلاسیک. DeepSeek توان تولید ویدیو ندارد و صفر امتیاز میگیرد.
Round 1: Image-to-video from the iconic photo of Neil Armstrong on the Moon

Sora 2 از متحرکسازی مستقیم افراد امتناع کرد، بنابراین ما دوباره با توصیف متنی درخواست دادیم. نتایج صوتی بهطرز غافلگیرکنندهای قوی بودند.
Gemini: بیشترین حس سینمایی و بهترین تطابق صدا؛ اما لغزش فیزیکی: پرچم تکان میخورد که در خلأ امکانپذیر نیست.
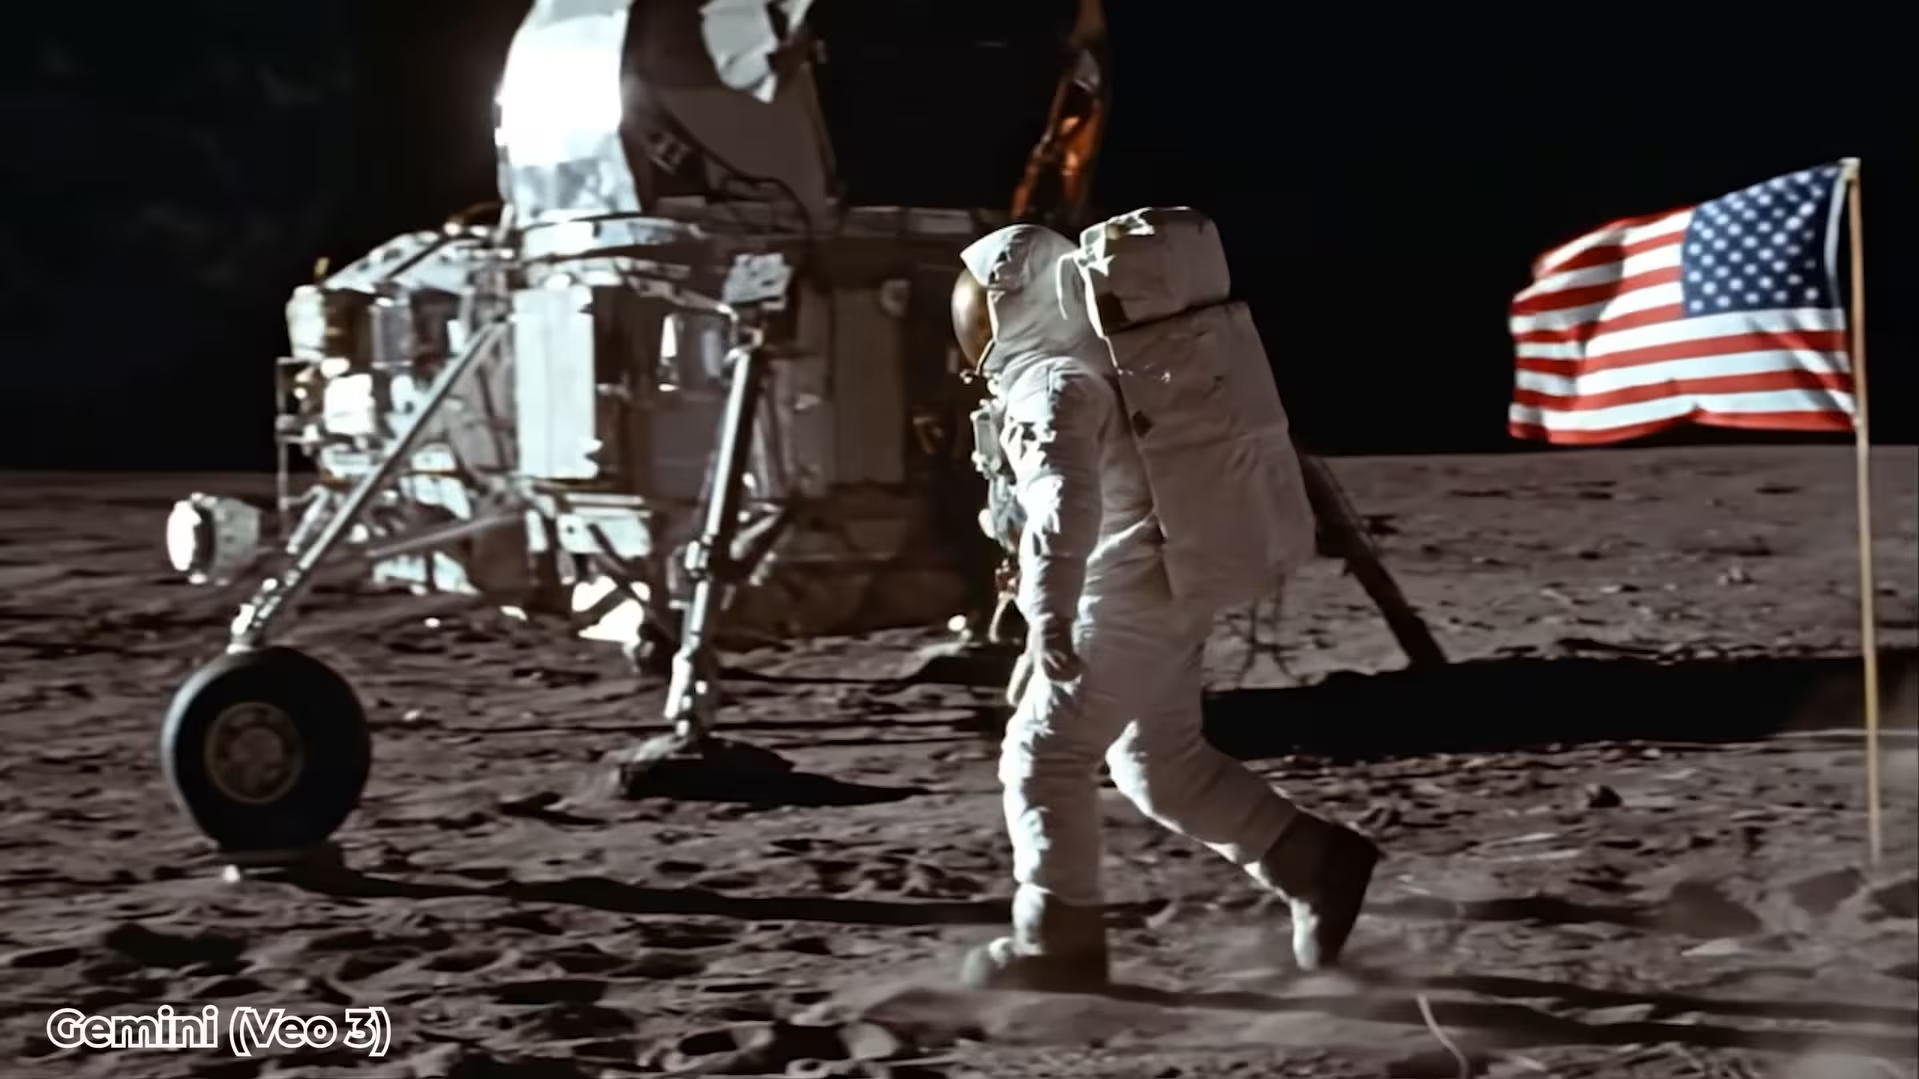
Grok: کلیت خوب است، اما مقیاس سفینه نادرست است و باد دیده میشود.

ChatGPT: قابلقبول اما نسبت به دو مورد دیگر کمتر جذاب.

Scores
Gemini 4, Grok 3, ChatGPT 2, DeepSeek 0.
Round 2: Steel-beam workers high above the city
Gemini: بهترین حرکت دوربین و پارالاکس؛ اما سیگارها کمی نامناسب به نظر میرسند.

Grok: حس تنش با تیرچهٔ تابان قوی است؛ روزنامهها در میانهٔ صحنه بهطرز غیرواقعی تغییر شکل میدهند.
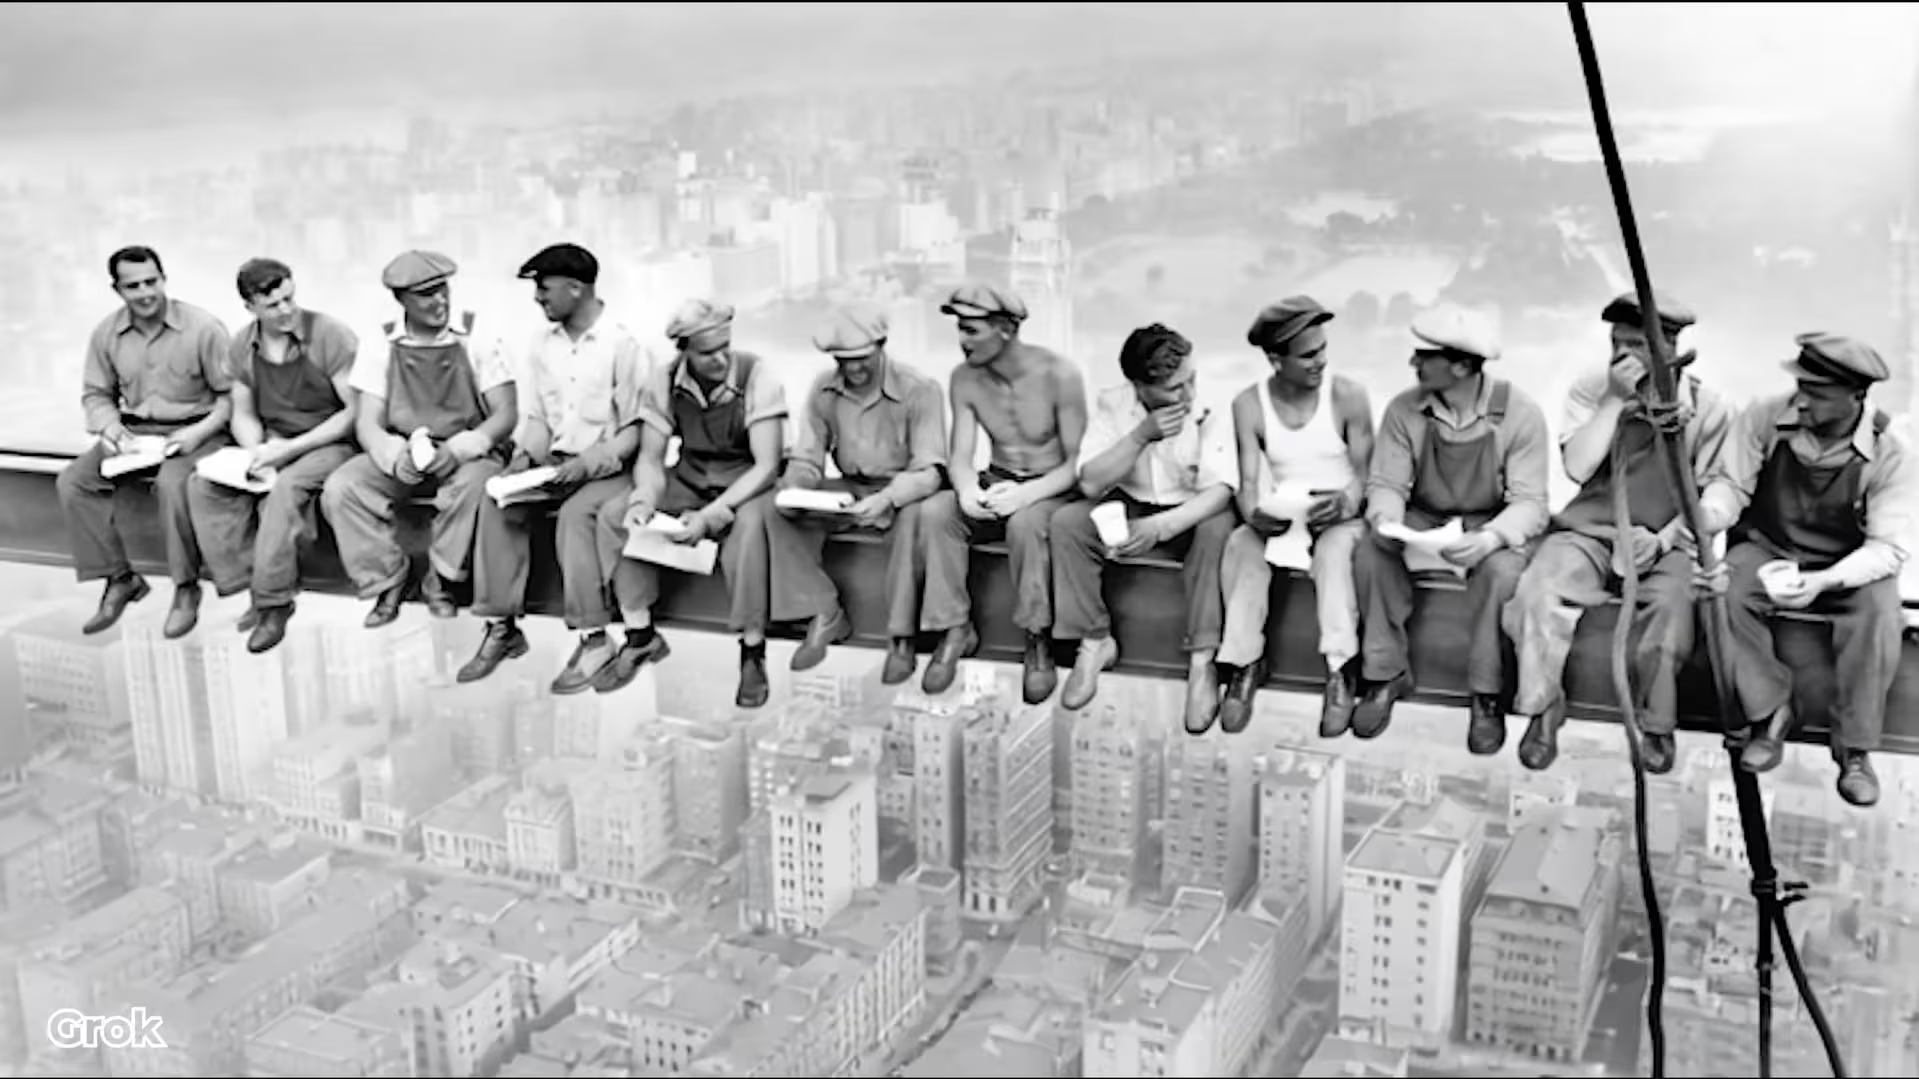
ChatGPT: شایسته اما در صدر نیست.

Scores
Gemini 4, Grok 3, ChatGPT 2, DeepSeek 0.
Video Generation Totals
| Model | R1 | R2 | Total |
|---|---|---|---|
| Gemini | 4 | 4 | 8 |
| Grok | 3 | 3 | 6 |
| ChatGPT | 2 | 2 | 4 |
| DeepSeek | 0 | 0 | 0 |
تفسیر: Gemini با کیفیت حرکت و طراحی صوتی پیشتاز است. Grok نزدیک است اما خطاهای واقعگرایانه دارد. ChatGPT پایدار است اما کمتر سینمایی.
Category 6: Creative Generation
دو درخواست کوتاه برای بازیهای زبانی (پان) و لطیفههای نوع "dad joke".
Prompt 1: Three original tech puns and a one-sentence explanation for each
هر چهار مدل بهخوبی پاسخ دادند. مورد محبوب تیم:
«سعی کردم دربارهٔ USB جوک بسازم، اما واقعاً گیر نکرد.»
Scores
ChatGPT 3, Gemini 3, Grok 3, DeepSeek 3.
Prompt 2: Three original dad jokes that make me laugh really hard
Grok در دنبال کردن کلیت درخواست ناموفق است و مدام دربارهٔ گوشیهای هوشمند و وایفای شوخی میکند.
ChatGPT, Gemini, DeepSeek لطیفههای عام پدرانهٔ واقعی تولید کردند. مورد محبوب تیم:
«نانوایی دوستم شب گذشته سوخت. حالا کسبوکارش توست است.»
Scores
ChatGPT 4, Gemini 4, DeepSeek 4, Grok 1.
Creative Totals
| Model | Puns | Dad Jokes | Total |
|---|---|---|---|
| ChatGPT | 3 | 4 | 7 |
| Gemini | 3 | 4 | 7 |
| DeepSeek | 3 | 4 | 7 |
| Grok | 3 | 1 | 4 |
تفسیر: سهراهی برای اول شدن. DeepSeek یادآوری میکند که طنز سبک و سریع یکی از تواناییهای پرانرژی آن است.
Category 7: Voice Mode
سه دستگاه را کنار هم قرار دادیم و مناظرههای ساختاریافتهٔ کوتاهی اجرا کردیم. DeepSeek حالت صوتی ندارد و صفر امتیاز گرفت.
ChatGPT با مکثهای عجیب و تغییرات لحن در وسط جمله شروع میکند.
Gemini روانتر و طبیعیتر است و ریتمی یکنواخت دارد.
Grok سریع، بااعتمادبهنفس و کمی تند است؛ در رویارویی با Gemini هر دو قوی بهنظر میرسند و آن را تساوی اعلام میکنیم.
Scores
Gemini 4, Grok 4, ChatGPT 2, DeepSeek 0.
تفسیر: اگر به گفتوگوی صوتی طبیعی نیاز دارید، Gemini و Grok بهترین گزینهها در حال حاضر هستند.
Category 8: Deep Research
دستور: iPhone 17 Pro Max را با Galaxy S25 Ultra برای عکاسان مقایسه کنید، از بررسیها و مشخصات رسمی استفاده کنید، تصمیم بگیرید کدام بهتر است و مختصر باشید.
DeepSeek بهاشتباه مدعی تلهفوتوی 5x روی آیفون شد در حالی که 4x است، و اولتراواید گلکسی را 12 مگاپیکسل گزارش کرد درحالیکه 50 است؛ همچنان به لنز 10x اشاره میکند که از S24 حذف شده است.
ChatGPT تنظیم دوگانهٔ تله در گلکسی را فراموش میکند و دوربینهای جلویی را حذف میکند، اما قیمت را ذکر میکند.
Gemini آرایهٔ دوربین درست گلکسی را لیست میکند و نتیجهگیری متعادل ارائه میدهد.
Grok کاملترین و دقیقترین مرور مشخصات را ارائه میدهد.

هر چهار مدل در حکم کلی همنظرند: آیفون برای پایداری و کیفیت ویدیو برنده است؛ گلکسی برای زوم بلند و ابزارهای پیشرفتهٔ هوش مصنوعی بهتر است. این با تجربهٔ عملی همخوانی دارد. با این حال، جزئیات پراکندهٔ مشخصات نیاز به راستیآزمایی دارند.
Scores
Grok 4, Gemini 3, ChatGPT 2, DeepSeek 1.
تفسیر: Grok در کار پژوهشی سنگین پیروز است، Gemini نزدیک پشت سر، ChatGPT مفید اما برخی حقایق کلیدی دوربین را از دست داد و DeepSeek نیازمند دقیقتر شدن در مشخصات است.
Category 9: Speed (Observed, Not Scored)
ChatGPT در متن ساده سریعترین حس میشود اما در وظایف تصویری و پژوهش عمیق کند میشود.
Gemini در تقریباً همهجا ثابتقدم است؛ به ندرت بسیار سریع و تقریباً هرگز کندترین نیست.
Grok معمولاً تند است اما در تحلیل و پژوهش ممکن است کند شود.
DeepSeek اغلب زیر 10 ثانیه پاسخ میدهد، اما این سرعت اغلب بهقیمت از دست رفتن زمینه و دقت تمام میشود.
ما سرعت را بهعنوان یک دستهٔ مستقل نمرهدهی نکردیم تا در مجموع امتیازها با مسابقهٔ مرجع همترازی داشته باشد.
Full Scoreboard
برای شفافیت، جدول کامل امتیازها به ازای هر دسته اینجاست که با ترازهای نهایی مسابقهٔ منبع مطابقت دارد.
| Category | ChatGPT | Gemini | Grok | DeepSeek |
|---|---|---|---|---|
| Problem Solving | 7 | 7 | 5 | 3 |
| Image Generation | 7 | 5 | 4 | 0 |
| Fact-Checking | 6 | 9 | 7 | 4 |
| Analysis | 4 | 3 | 2 | 0 |
| Video Generation | 4 | 8 | 6 | 0 |
| Creative | 7 | 7 | 4 | 7 |
| Voice Mode | 2 | 4 | 4 | 0 |
| Deep Research | 2 | 3 | 4 | 1 |
| Total | 39 | 46 | 35 | 17 |
Overall winner: Gemini (46 points).
Runner-up: ChatGPT (39). Third place: Grok (35). Fourth place: DeepSeek (17).
Strengths, Weaknesses, and Failure Modes
مقایسهٔ رودررو تنها زمانی مفید است که توضیح دهد چرا مدلها آنطور رفتار میکنند که میکنند. اینها الگوهای ثابتی هستند که مشاهده کردیم.
ChatGPT
Strengths: استدلال ساختاریافتهٔ قوی در شرایط محدودیت؛ تحلیل تصویر محافظهکارانهتر و کمتر مبتلا به هالوکینیشن؛ تولید تصویر فوتورئال غیرمعمول قوی؛ نگارش خلاق قابلاعتماد و دقیق.
Weaknesses: در کارهای چندرسانهای سنگین کند میشود؛ گاه حذف مشخصات در پژوهش؛ تحویل صوتی نیاز به پایداری بیشتر در پروسودی دارد.
Failure modes to watch: شکافهای کوچک اما مهم در حقایق هنگام مقایسهٔ چنددستگاهی؛ پاسخهای کممشخص اگر پرسش بیش از حد خلاصه باشد.
Pick ChatGPT if: به تولید تصویر فوتورئال که به پرامپتها پایبند باشد، برنامهریزی گامبهگام یا نگارش خلاق نیاز دارید که تمیز و پیوسته تحویل دهد. برای منطق غذا و دستور آشپزی زمانی که موجودی ناقص است نیز عالی است.
Gemini
Strengths: بهترین توازن کلی؛ در بررسی واقعیت بدون مرورگر دقیق است؛ قانعکنندهترین خروجی ویدیویی و صحنهآرایی صوتی؛ حل مسئلهای که برنامه را تطبیق میدهد بهجای دست کشیدن از محاسبات؛ روانترین صدا.
Weaknesses: گاه در تصاویر کمی بیش از حد صیقل میخورد؛ ممکن است جزئیات جذاب اما خیالی به تحلیل تصویری اضافه کند؛ بهندرت سریعترین است.
Failure modes to watch: فرامین فوتورئال که نیاز به تایپوگرافی یا دقت کامل آناتومی انسان دارند میتواند آن را به مشکل بیندازد؛ در ویدیو صریح بودن دربارهٔ قیدهای فیزیک ضروری است.
Pick Gemini if: میخواهید یک مدل پیشفرض که اکثر وظایف را بسیار خوب انجام میدهد، بهویژه هنگامی که کار ترکیبی از استدلال و تولید چندرسانهای است و به درستی اهمیت میدهید.
Grok
Strengths: پژوهش عمیق عالی؛ شخصیت قوی در حالت صوتی؛ پاسهای اول سریع؛ درک خوب از ساختار مناظره.
Weaknesses: هالوکینیشن در تحلیل تصویر؛ شکستهای واقعیتگرایانه در ویدیو؛ گاه تمرکز تونلی در درخواستهای خلاقانه.
Failure modes to watch: اقلام اختراعی در عکسها؛ جزئیات غلط اما با اعتماد به نفس؛ پافشاری روی تمی که دیگر منسوخ شده وقتی که پرسش تغییر کرده است.
Pick Grok if: نیاز به همکار پژوهشی تیز برای تجمیع مشخصات و بررسیها یا حضور صوتی پرانرژی دارید. هنگام ضرورت دقت، همراهی با راستیآزمایی دستی توصیه میشود.
DeepSeek
Strengths: در متن سریع؛ در طنز کوتاه و سبک عملکرد قابلتوجهی دارد؛ در پیروی از درخواستهای سادهٔ خلاقانه خوب عمل میکند.
Weaknesses: توانایی تصویر یا ویدیو ندارد؛ قادر به شناسایی اشیاء در تصاویر نیست؛ در پژوهش دقت کمتری دارد.
Failure modes to watch: اعداد با اعتمادبهنفس اما کجنمایی شده؛ خواندن متن داخل تصاویر در حالی که صحنه را نادیده میگیرد.
Pick DeepSeek if: میخواهید خروجی متن ارزان و بسیار سریع برای وظایف ساده، لطیفهها یا پیشنویسها که قرار است ویرایش شوند دریافت کنید.
Practical Recommendations by Use Case
Photoreal image generation with strong prompt adherence: ChatGPT
Image analysis without hallucinated objects: ChatGPT
Video generation with better motion and sound design: Gemini
Tough fact-checking without browsing: Gemini
Problem solving under constraints: Gemini and ChatGPT
Natural, steady voice conversation: Gemini and Grok
Spec comparisons and product research summaries: Grok
Quick, lightweight creative text: DeepSeek
Why the Winner Matters Less Than the Fit
Gemini بیشترین امتیاز را گرفت چون بین دقت، سازگاری و کیفیت چندرسانهای تعادل برقرار میکند. این توازن در مسابقات برنده میشود. در کار واقعی، مهمتر از رتبهٔ کلی «تناسب با وظیفه» است. اگر روز کاری شما حول تصاویر ایستا میچرخد، ChatGPT ممکن است بهتر از آنچه نمرات نشان میدهند برای شما عمل کند. اگر جدول مشخصات میچینید، Grok ممکن است سریعترین مسیر به پیشنویس منتشرشدنی باشد. اگر به یک لطیفهٔ سریع یا پیشنویس خام نیاز دارید، سرعت DeepSeek یک مزیت است نه ایراد.
این مدلها را مانند لنزهای یک کیف دوربین در نظر بگیرید. بهترین لنز روی کاغذ لزوماً آن چیزی نیست که همیشه نیاز دارید. فاصلهٔ کانونی را بر اساس نما انتخاب کنید.
Limitations and Notes on Reproducibility
No internet rounds: همهٔ مدلها از دانش نهفتهٔ خود استفاده کردند که با زمان قدیمی میشود. اگر این آزمایشها را ماهها بعد تکرار کنید، اعداد و حقایق ممکن است با بهروزرسانیهای مدل یا دادهها تغییر کنند.
Generative variability: تصادفیبودن اجرای مجدد میتواند واژهبندی یا جزئیات کوچک را تغییر دهد. ما با تمرکز بر درستی و پایبندی به خواستهها (adherence) و نه زرقوبرق عبارتها، این مسئله را کنترل کردیم.
Speed: بهصورت کیفی ثبت شد. زیرساخت و بار کاری تأثیرگذارند؛ سریعترین امروز ممکن است فردا کندتر به نظر برسد.
Modal gaps: هرجا قابلیتی وجود ندارد (مثل تصاویر و ویدیو برای DeepSeek)، صفر بودن امتیاز ضمناً بهمعنای ضعف در متن نیست؛ صرفاً دامنهٔ محصول را بازتاب میدهد.
Verdict
Winner: Gemini (46 points). بهترین مدل همهجانبه برای 2025، با نتایج برجسته در بررسی واقعیت، تولید ویدیو و حل مسئلهٔ تطبیقی، همراه با روانترین صدا.
Runner-up: ChatGPT (39 points). پیشتاز تولید تصویر فوتورئال، حلکنندهٔ ساختاریافتهٔ مسئله، شریک خلاق قابلاعتماد و محتاطترین در تحلیلهای مبتنی بر تصویر.
Third: Grok (35 points). متخصص پژوهش با شخصیت صوتی متمایز. هنگام نیاز به دقت، جزئیات را تصدیق کنید.
Fourth: DeepSeek (17 points). سریع، ساده و برای خلاقیت سبک و کمریسک بهطور غیرمنتظرهای لذتبخش، اما از عمق چندرسانهای رقبا بیبهره است.
اگر یک مدل میخواهید که گستردهترین مجموعهٔ وظایف روزمره را با کمترین شگفتی انجام دهد، Gemini را انتخاب کنید. اگر جریان کاریتان روی تصاویر است و به استدلال گامبهگام اهمیت میدهید، ChatGPT برایتان آشنا خواهد بود. برای شرحوارههای مشخصات و مناظرههای صوتی موجز، Grok جذاب است. برای متن سریع و کمریسک که هزینه و سرعت مهمتر از گستردگی است، DeepSeek ارزش خود را نشان میدهد.
نه دسته. یک جدول امتیازات. فضای زیادی برای نکتهها و ظرافتها وجود دارد. ابزار مناسب را انتخاب کنید، و هر یک از این مدلها میتواند همتیمی هوشمند شما در اتاق باشد.

نظر بگذارید
نظرات (12)
این نوع رتبهبندی رو میتونستی بهتر با مثالهای واقعی کاربری نمایش بده. نکتهها مفیدند.
خوشحال شدم Gemini بیشتر از بقیه توانایی تعادل داره؛ اما هنوز راستیآزمایی لازم است.
سرعت خوبه اما اهمیت ندارد اگر مدل نتونه جزئیات رو درست نگه داره.
این نتیجهگیریها خوبه، اما واقعاً باید با کاربری که داری انجام میدی همگام باشی.
وقتی ورودی نامنظم میشه Grok گاهی فکر میکنه چیزهای خیالی اضافه میکنه.
برای پاسخهای دقیق درباره مشخصات گوشیها Grok شاید مفیدتر باشه؛ اما باز هم باید تأیید کرد.
راستی بدون اینترنت یعنی خیلی از منابع قطع میشن. راستیآزمایی لازمه.
برای تولید ویدیو بهتره Gemini رو نگه داریم چون صدا و حرکت هماهنگی داره.
DeepSeek سرعت بالا برای پیشنویسها عالیه اما تو ویدئو و تصاویر مشکل داره.
شفاف بودن امتیازات خیلی ارزشمنده. اما گاهی دقت عددی تو واقعیت مهمتر از سرعتشه.
به نظر من نقطه کلیدی اینه که هیچ مدل همیشه بهترین نیست. کاربرد واقعی تعیین میکنه کی رو انتخاب کنیم.
این مقایسه رو دنبال کرده بودم، نتیجهاش واقعاً جالب بود. Gemini و ChatGPT هر کدوم در یه زمینه عالی عمل میکنن.